⚡ 30 秒速记
- 核心判断:性能优化先建立用户指标与资源、主线程、渲染和网络证据,再定位最长关键路径
- 原理主线:围绕 「回顾原生 DOM 下的事件流」、「React 事件系统是如何工作的」、「React 事件系统工作流拆解」 建立输入、状态变化与输出之间的因果关系
- 文章范围:对比了 React 事件与原生 DOM 事件的区别,解析了事件流、事件委托、合成事件机制及其在性能优化和跨浏览器兼容性方面的优势,帮助开发者深入理解 React 事件系统的设计原理和实际应用场景。
- 边界与代价:实验室分数不等于真实用户体验,平均值也会掩盖长尾;优化一项指标可能转移成本
- 工程落地:用现场数据确定瓶颈、做最小改动、对照验证并持续监控回归
React 事件不是直接使用原生 DOM 事件,而是基于事件委托封装出的合成事件系统。 原生事件按捕获、目标、冒泡传播;React 则统一监听并收集组件树上的回调,再按相同顺序执行,同时抹平浏览器差异。需要原生对象时,可通过 e.nativeEvent 获取。实现边界要看版本:React 16 主要委托到 document,React 17 以后改为根节点,少数不可冒泡事件还需特殊处理。
这篇文章不要按 API 清单来背。先用上面的 Mind Map 建立全局结构,再通过交互 DEMO 观察正常路径和边界路径如何改变状态;阅读正文时重点核对每一步的输入、负责执行的参与者、产生的中间状态以及最终可观察结果。遇到版本敏感结论,要把“历史实现”“当前行为”和“工程兼容策略”分开说明;遇到性能或架构取舍,则用实际指标、失败现象和验证手段支撑判断。
版本校准: 本文若分析 ReactDOM.render、旧生命周期或栈调和,应把它视为理解架构演进的历史路径。React 19 已移除 ReactDOM.render,当前客户端入口使用 createRoot;并发渲染也必须区分可中断的渲染阶段与同步提交阶段。迁移前对照 React 19 官方升级指南。
注:本文逻辑提取自
React 16.13.x。随着 React 版本的更迭,事件系统的实现细节难免有调整,但其设计思想总是一脉相承的,你只要把握住核心逻辑即可。
# 回顾原生 DOM 下的事件流
在浏览器中,我们通过事件监听来实现 JS 和 HTML 之间的交互。一个页面往往会被绑定许许多多的事件,而页面接收事件的顺序,就是事件流。
W3C 标准约定了一个事件的传播过程要经过以下 3 个阶段:
- 事件捕获阶段
- 目标阶段
- 事件冒泡阶段
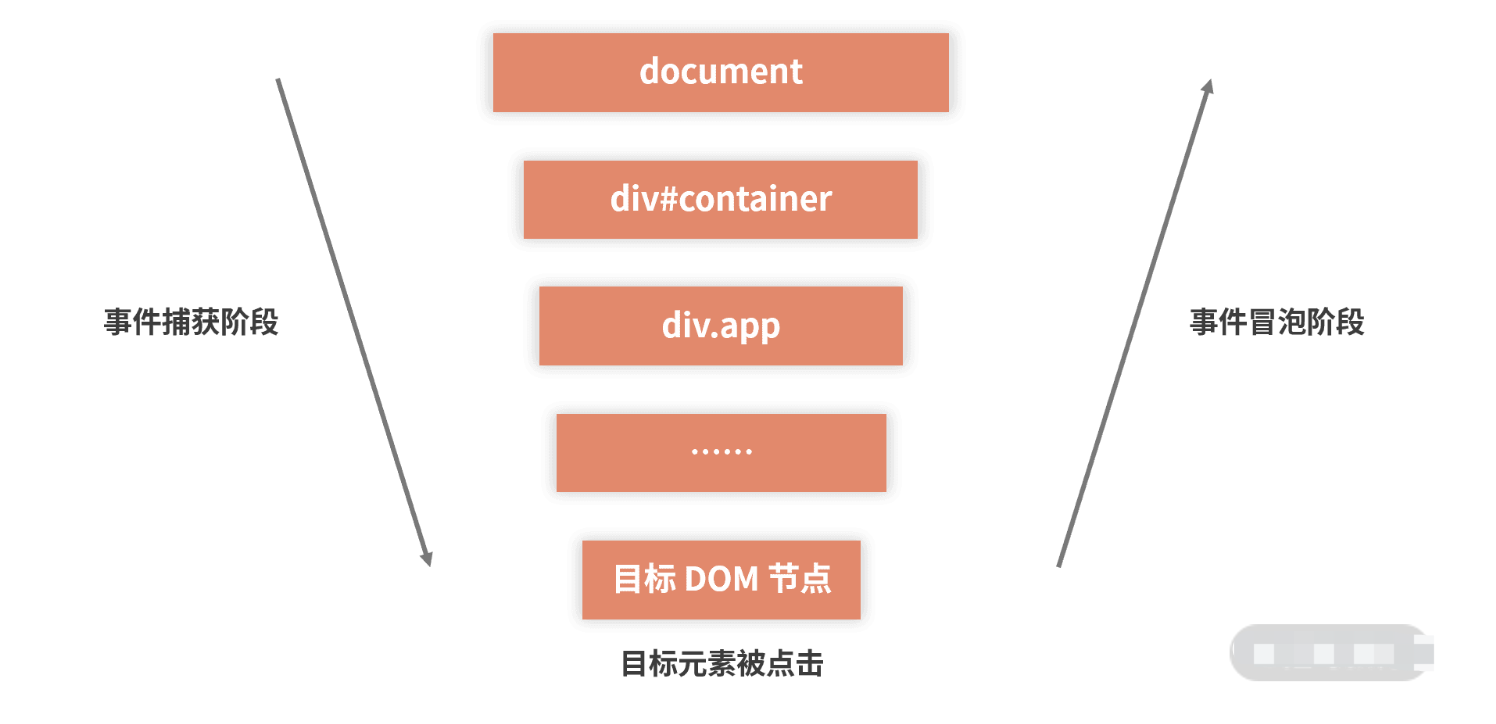
当事件被触发时,首先经历的是一个捕获过程:事件会从最外层的元素开始“穿梭”,逐层“穿梭”到最内层元素,这个过程会持续到事件抵达它目标的元素(也就是真正触发这个事件的元素)为止;此时事件流就切换到了“目标阶段”——事件被目标元素所接收;然后事件会被“回弹”,进入到冒泡阶段——它会沿着来时的路“逆流而上”,一层一层再走回去。


